

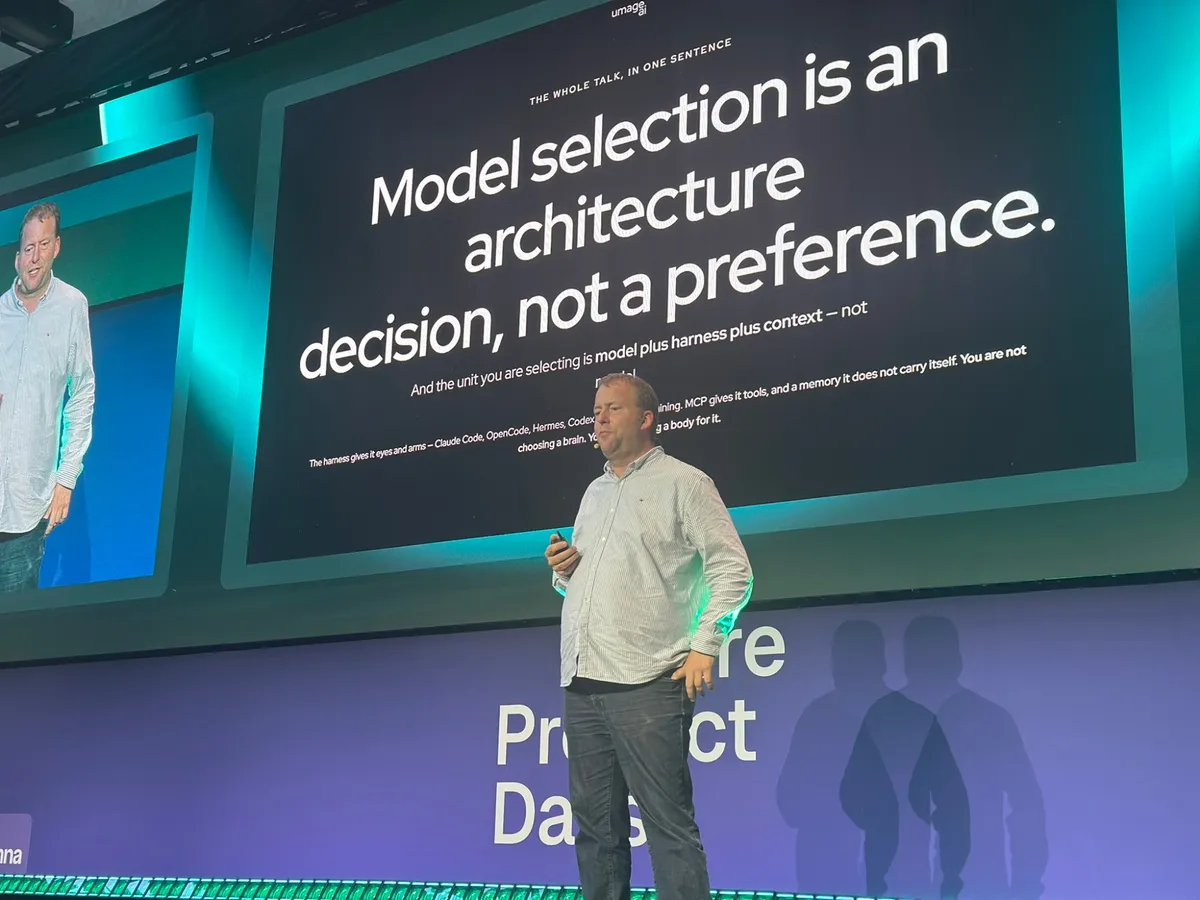
Jeg holdt dette foredrag i dag på Future Coding Day 2026 i København. Her er hele budskabet i én sætning, slidesne til download, to andre foredrag fra dagen, der er værd at se, og en oversigt over de opfølgende artikler, der er på vej.
Jeg holdt et foredrag i dag på Future Coding Day 2026 i København. Tredive minutter med spørgsmål — ikke nok til at argumentere et synspunkt fuldt igennem, men rigeligt til at slå det fast én gang og underbygge det med et tal, ingen i lokalet kan komme udenom.
Titlen var Long-Distance Relationship: You and Your LLM. Udgangspunktet er tre reelle problemer ved at lægge sit kritiske arbejde over på en frontier-model i et datacenter, man hverken ejer eller kan se — for det ligger på den anden side af jorden, i USA eller Kina, under love man ikke selv har stemt om.
Penge. To Claude Code-sessioner brugte €170 i udløbende kreditter på tre timer en fredag — der skete ikke noget usædvanligt, der var bare ingen, der holdt øje med måleren. Data. En agent, der dekompilerer en licenseret pakke for at forstå et udokumenteret API, sender den dekompilerede kode med i samme prompt. Og “vi træner ikke på jeres data” er ikke det samme løfte som “vi gemmer det ikke” — en domstol kan tilsidesætte en leverandørs opbevaringspolitik, uanset hvad leverandøren selv havde tænkt sig, og det er allerede sket. Forsyning. I juni i år satte en amerikansk eksportkontrolordre to frontier-modeller ud af drift for samtlige kunder på kloden — uden varsel, i atten dage. Det er ikke et argument for, at nogen leverandør har gjort noget forkert. Det er, hvad der sker, når den infrastruktur, man er afhængig af, ligger i udlandet — og man har indrettet sig, som om det var for evigt.
Det betyder ikke, at man skal droppe frontier-modeller. Det betyder, at man skal vide, hvad hver opgave faktisk kræver — i stedet for automatisk at gribe til den dyreste løsning.
Kapacitet er ikke evne
Hele foredraget i én sætning står på slidet bag mig på billedet ovenfor — det er slidets egne ord, ikke mine:
Model selection is an architecture decision, not a preference.
Det, man reelt vælger, er ikke bare en model — det er model plus harness plus kontekst. Man vælger ikke en hjerne, man vælger en krop til den. Det, der afgør, om en model er god til en opgave, er ikke antallet af parametre, men hvor godt den er trænet, hvilket harness den kører i, og hvilke skills, tools og MCP’er den har adgang til. Nogle open-weight-modeller er blevet rigtig gode — og det har jeg målt, ikke bare påstået: samme fastlåste opgave, en ray tracer i Python med fem milepæle, kørt gennem Opus i et datacenter og qwen3.8:27b på mine egne GPU’er, med samme harness hele vejen.
| Opus (frontier, datacenter) | qwen3.8:27b (lokal, vLLM) | qwen3.8:27b (lokal, Ollama) | |
|---|---|---|---|
| Varighed | 27 min | 1t 50 | 2t 38 |
| Rendertid ved milepæl 5 | 18,7s | 23,6s | 48,7s |
| Kodelinjer skrevet | 699 | 420 | 467 |
| Output | Identisk | Identisk | Identisk |
Og det er ikke bare det samme billede — tre forskellige regnemetoder landede på nøjagtig samme SHA-256-hash. Til gengæld var det langsommere, og koden fra de lokale kørsler var kortere undervejs. Men det kørte hele natten på forbruger-GPU’er, jeg selv ejer, uden at nogen holdt øje — for det var der ingen grund til. Og ingen af de lokale kørsler afbrød undervejs med en mail om, at tokengrænsen var nået, sådan som en hostet plan ville gøre midt i en opgave. Når ingen venter, er langsommere ligegyldigt — det er den samme €170-historie fra indledningen, bare set fra den anden side.
Det hænger også sammen med, at størstedelen af en agentisk session slet ikke er den svære del. Jeg har engang gennemgået en rigtig fejlsøgningssession fra start til slut: fyrre tool calls på tolv minutter for at rette én fejl i produktionen. De tredive var glob, grep og read — bare søgning efter fejlen. Ni kørte et build for at tjekke rettelsen. Én var selve rettelsen. Ud af fyrre tool calls krævede kun én noget, man kunne kalde intelligens. Resten var mekanisk benarbejde, som en veldefineret model klarer lige så godt — frontier eller ej.
Hvad hører til hvor
Sådan vil jeg dele det op i praksis: kør open-weight-modeller lokalt om natten til alt det, ingen behøver at holde øje med — autonome agenter eller batch-jobs. Det kan være at dokumentere dependency-kode, opbygge et RAG-indeks over sin egen kodebase, eller køre release-gate-tjek, inden noget som helst må merges. Frontier-modellen er til planlægning og specificering af arbejdet i første omgang — den del, der rent faktisk får noget ud af mere dygtighed frem for bare flere parametre.
Hent slidesne
Hele præsentationen — 38 slides, benchmark-tabellen, “dagvagt, nattevagt”-argumentet og playbooket til sidst — kan hentes som PDF: Long-Distance Relationship: You and Your LLM (PDF).
To foredrag, der spillede godt sammen med mit
Future Coding Day er den nyere, mere fokuserede lillebror til Future Product Days, og de to tilsammen var hvert minut værd — stærke foredrag hele vejen igennem, gode samtaler mellem sessionerne, og mere ægte inspiration, end jeg havde regnet med. Selve Coding Day kører et stramt program — engineers, CTO’er og founders, der bygger agentiske systemer, ingen sponsorerede indlæg — og to sessioner på dagen ramte særligt tæt på mit eget budskab. Dem vil jeg pege jer direkte hen imod.
Matthias Laus The Hidden Economics of Agentic Software Engineering (Heureka Labs) kom lige efter mit eget på programmet, og det var det rigtige foredrag at følge op med. Mit argumenterer for, at modelvalg er arkitektur. Hans går direkte til økonomien i den arkitektur: dynamisk model-routing, hvorfor et statisk “brug altid frontier-modellen”-valg holder op med at skalere, så snart man kører parallelle agent-workflows, og de åbne designspørgsmål om, hvornår et routing-valg reelt bør tilpasse sig. Hvis I kun skal se ét andet foredrag fra dagen, så se det.
Paul Stacks When AI Writes the Code (Swamp Club) laver et beslægtet, men anderledes argument: erstat pull requests med issues, lad designbegrænsningerne gøre arbejdet på forhånd, og behandl “skarpe begrænsninger giver god kode” som den reelle mekanisme frem for et slogan. Det, der blev hængende hos mig, var gatingen — tjek og adversarial-agent-review, der kører, før noget som helst må merges. Det er præcis det release-gate-arbejde, jeg mener hører hjemme på en lokal model frem for en frontier-model. Hans foredrag og mit landede på samme slags svar fra to forskellige retninger, samme dag, uden at nogen af os vidste, hvad den anden var i gang med at bygge.
Kommende posts
Tredive minutter rækker til formen på et argument, ikke til beviserne for det. I løbet af de næste uger skriver jeg de dele op, der ikke var plads til på scenen: hele benchmarket og dets metode, argumentet for at tilpasse modelstørrelsen til opgaven, hvad der reelt forlader ens maskine i en prompt, hvorfor en cloud-LLM er en jurisdiktionsrisiko og ikke bare en leverandørrisiko, hvad en nats GPU-tid reelt er værd, og et par ting der først gav mening at skrive, da jeg holdt op med at bekymre mig om at virke seriøs på scenen. Jeg linker hver enkelt her, efterhånden som de udkommer.
Hvis I var i salen i dag — tak for at komme, og for spørgsmålene bagefter. Hvis I ikke var, ligger slidesne ovenfor, og resten er på vej.