

Claude er en genial udvikler, der aldrig har set Optimizely. Sådan gav vi vores agenter den framework-erfaring, et menneske skal bruge et halvt år på at opbygge: omkring 1.400 sammenlinkede noter, en verificeringsproces, der stoler mere på de kompilerede pakker end på blogs, og et indeks over 14.424 NuGet-pakkeversioner.
Når jeg skal forklare folk uden for Optimizely-verdenen, hvordan vi arbejder med agenter, griber jeg hver gang til den samme analogi: behandl dem som medarbejdere.
Nogle er geniale, og andre er knap så kloge. Nogle er meget selvstændige, mens andre har brug for en del vejledning. Men de skal alle sammen sætte sig ind i jeres forretning, jeres procedurer og den måde, I arbejder på. De skal have adgang til de værktøjer, I allerede bruger, som Linear, DevOps, GitHub og resten. Og når arbejdet bygger på et stort framework, skal de have erfaring med netop det framework og med de community-pakker, der findes omkring det.
Det sidste var emnet for mit oplæg ved Optimizely Copenhagen Developer Meetup. Det hed “Brilliant and ignorant”, og jeg har endnu ikke fundet en mere præcis beskrivelse af en frontier-model på et Optimizely-projekt.
En genial nyansat, der aldrig har set Optimizely
Claude er rigtig god, lige som den kommer ud af æsken. Giv den en Optimizely-opgave, og den når i mål til sidst. Men se, hvordan den kommer derhen. Den slår ting op. Den gætter på et API, får en compilerfejl og gætter igen. Den dekompilerer DLL-filer med stor begejstring, som om ingen nogensinde har fortalt den, hvor dokumentationen ligger. Og når den er færdig, opdager I måske, at den har skrevet en hjælpemetode, som allerede findes i Optimizely, eller genopfundet noget, som alle andre for længst har løst med en og samme community-add-on.
Det er ikke et problem med modellen. Det er et erfaringsproblem, og det har vi set før.
En god udvikler har altid hurtigt kunnet komme i gang med Optimizely. Men der gik et halvt år og et par store projekter, før vedkommende kunne bestå certificeringen, for så lang tid tager det at lære, hvilket API der er det aktuelle, hvilket blogindlæg der er fra 2014, og hvilken add-on alle allerede bruger.
Sådan er det også med agenter, bare med én forskel, der ændrer alt. Når en menneskelig udvikler lærer noget, ved én udvikler det. Når en agent lærer noget og skriver det ned, ved alle agenter det. Hvis det ikke bliver skrevet ned, har en agent som udgangspunkt hukommelsestab: den knækker en svær nød, sessionen slutter, og det, den har lært, forsvinder med sessionen.
I mit forrige indlæg genopbyggede agenter vores site på CMS 13 med Visual Builder. Undervejs fandt de ud af, at Visual Builder-elementer ikke kan indeholde lister, content areas eller indlejrede blokke, og den opdagelse kostede sessionen en komplet ombygning af indholdsmodellen. I dag er den viden en verificeret note i vores videnbase, og den næste agent, der får brug for den, slipper med én søgning.
Tusind filer i en mappe
I kunne også bare pege jeres agenter mod Context7 eller en af de andre dokumentationstjenester, og de er virkelig gode. Men I har ingen kontrol over, hvad der står i dem, hvor opdateret det er, eller hvilken version det gælder for. Og ingen har tjekket noget af det mod de pakker, I faktisk kører. Et dokumentationsindeks fortæller jeres agent, hvad dokumentationen siger. Det fortæller ikke, hvad jeres projekt har lært.
Så vi byggede et sted, hvor agenterne kan gemme det, de selv lærer. Det er en intern videnbase, og i bund og grund er den ikke mere avanceret end som så: Markdown-filer i en mappe, linket sammen og lagt i git. Femogtyve år i den her branche, og så er state of the art en mappe.
Den første version blev bygget den 9. november i én lang session: 13 prompts fra mig, omkring 220 agenter til at lave arbejdet og 90 minutter fra første prompt til første commit. Siden er den blevet ved med at vokse, og i dag rummer den omkring 1.400 noter.
Sådan ser videnbasen ud i Obsidians grafvisning. Hver orange prik er en Optimizely-note, og stregerne er links mellem dem. Den lille blå og grønne klynge i hjørnet er alt det andet, firmaet ved om sine egne projekter, og det siger en del om, hvor stort et framework er.
Agenterne kommer til videnbasen på samme måde, som en kollega ville: via en MCP-server, ved at søge og ved at spørge den agent, der har ansvaret for den.
Det har vi fodret videnbasen med
Vi høstede viden alle de steder, hvor en erfaren Optimizely-udvikler selv har lært noget:
- Den officielle dokumentation og Optimizely World.
- 28 OMVP-blogs plus community-svar og GitHub.
- Viden trukket ud af rigtige kodebaser og gjort generisk, plus eksempelkodebaser, vi har genereret alene for at give agenterne noget at eksperimentere med og lære af.
- Opgraderingsprojekter, vi har lavet, hvor agenterne sammenlignede kodebasen før og efter opgraderingen for at se, hvad der faktisk ændrede sig.
Og så det ærlige forbehold, som jeg også tog på scenen. Det her er ikke mere viden, end vi havde i huset i forvejen. Det er flere filer. De noter, som er skrevet af folk, der selv har gjort arbejdet, er stadig de mest værdifulde. Forskellen er, at agenterne nu også kan læse dem sammen med alt det andet.
Sådan bliver en påstand “verified”
En høst, der beholder alt, er en høst, I ikke kan stole på. Blogindlæg modsiger hinanden, dokumentationen halter efter releases, og forumsvar handler med stor selvsikkerhed om en version, som ingen kører længere.
Derfor er vores verificeringsproces bygget som en nyhedsredaktion. Haiku, den billige model, læser og skriver udkast. Sonnet behandler hver eneste påstand i udkastene som ubekræftet, tjekker den mod den officielle dokumentation og de faktiske pakker og fletter, retter eller kasserer den derefter. En enkelt Opus-agent planlægger arbejdet og gennemgår resultatet. Den dyre model læste ikke én eneste side dokumentation. Den nøjedes med at uddelegere. Det kan man ikke sige om alle chefer.
Hver note har sin egen stamtavle:
applies_toangiver, hvilke versioner den gælder for: CMS 11, 12, 13.confidenceer entenverified,documented,communityellerunverified.sourcesoglast_verifiedfortæller, hvor den kommer fra, og hvornår nogen sidst har tjekket den.
Hver kilde har et tillidsloft. Et blogindlæg kan højst gøre en note community, uanset hvor god bloggen er. Den officielle dokumentation kan gøre noten documented. Kun de kompilerede pakker eller kørende kode kan gøre den verified. Når to kilder modsiger hinanden, registrerer noten konflikten og afgrænser den efter version eller hosting i stedet for i al stilhed at kåre en vinder. Blogindlæg skrev, at Search & Navigation, som de fleste af os stadig kalder Find, virker på CMS 13. Den officielle FAQ og pakkerne siger, at det gør den ikke. Noten gemmer begge dele og siger, hvilken af dem man skal tro på.
Her er en af noterne. Den er uredigeret, bortset fra at jeg har skiftet et internt kilde-id ud med et navn, man kan læse:
Regnskabet i dag lyder på 238 verified, 347 documented, 706 community og 127 unverified. Det er 706 noter, vi skylder folk, der har taget sig tid til at blogge og svare på spørgsmål om Optimizely. Tak, og undskyld det med tillidsloftet.
Processen smider også ting ud, og det er den del, jeg stoler mest på. Bloghøsten gav 327 udkast. Heraf blev 236 til nye noter og 53 kasseret, mens 94 indlæg blev sprunget over, for det meste fordi der var for lidt i dem at lære af. Og de agenter, der høstede viden om Commerce, opfandt typer. De beskrev ICartService og resten af familien med total selvsikkerhed, og verificeringen fandt intet af den slags i pakkerne. Hver eneste af de opfundne typer blev kasseret.
Processen fanger også vores egne fejl. Vores noter sagde, at ServiceLocator.Current.GetInstance<T>() ikke ville kompilere på CMS 13. Et rigtigt build på 13.5.1 viste det modsatte. IServiceLocator er væk, men den statiske ServiceLocator-klasse er der stadig og er ikke engang markeret som forældet. Det er netop den skelnen, noten i rammen ovenfor holder styr på.
Assemblies er den voksne i rummet
Den største enkeltkilde til verificeret viden er et indeks over Optimizelys NuGet-feed: indekset står bag 137 af de 238 noter, der er markeret som verified. Det rummer 902 pakker og 14.424 pakkeversioner, og det offentlige API for hver eneste af dem er trukket direkte ud af de kompilerede assemblies.
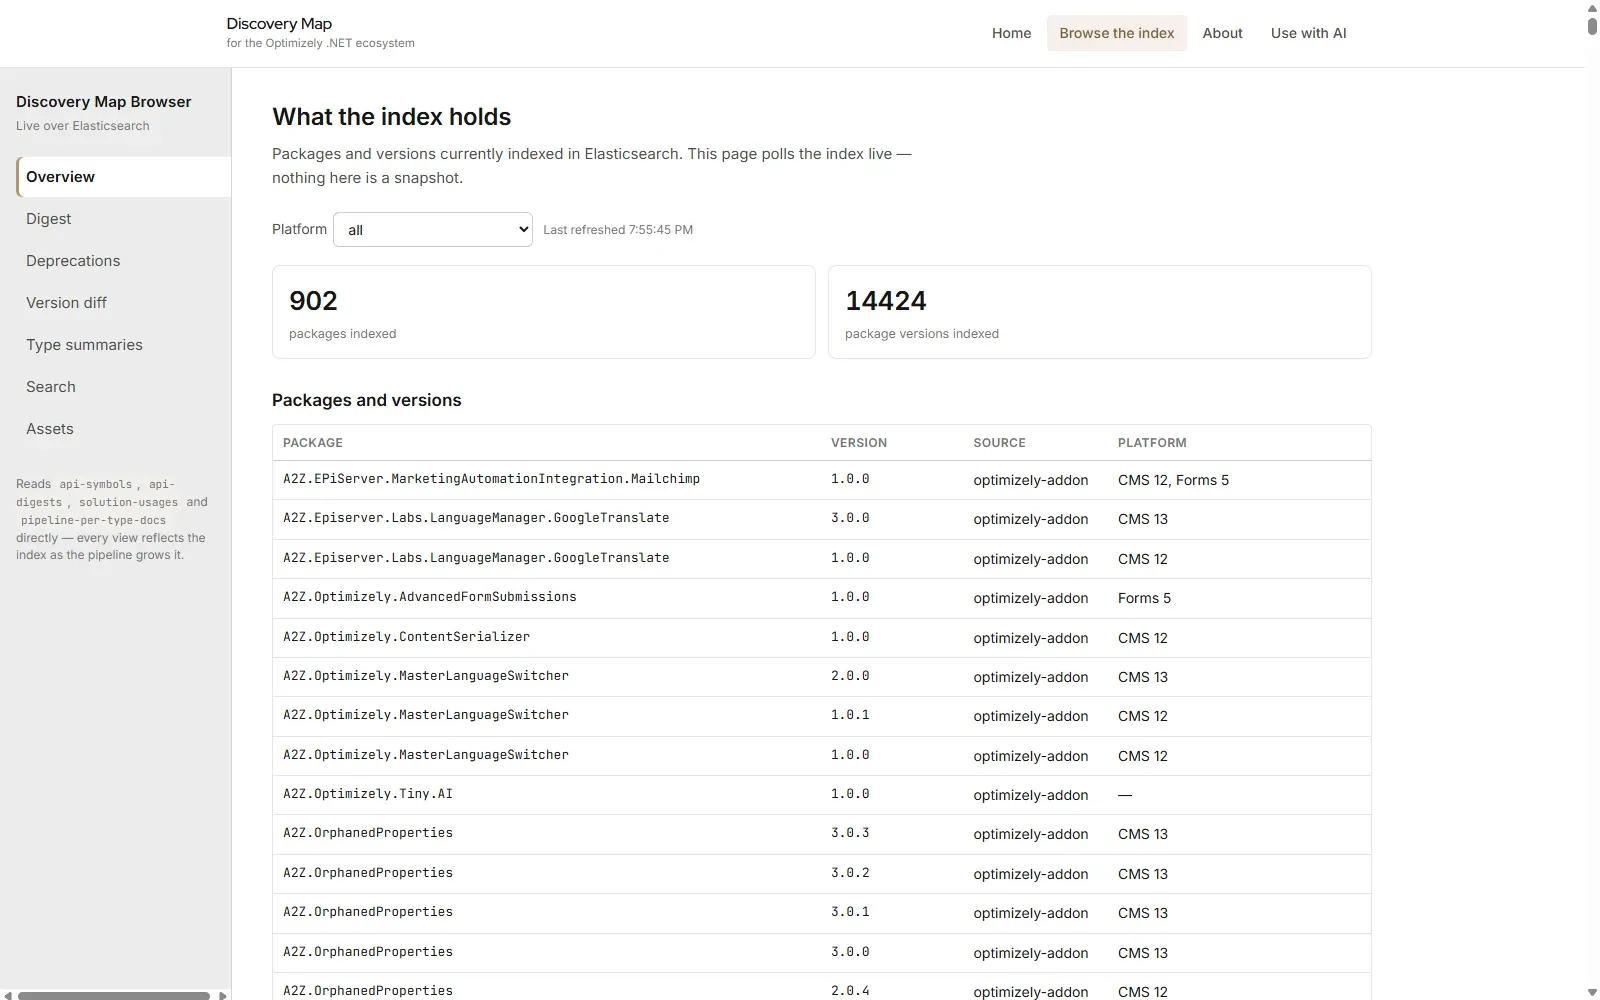
Et blogindlæg fortæller, hvad forfatteren troede om Optimizely, da det blev skrevet. Assemblies fortæller, hvad der faktisk ligger i den version, I kører. Når de to er uenige, vinder assemblies, hver gang.
En agent spørger indekset via MCP, så svaret kommer tilbage som strukturerede data i stedet for en websøgning:
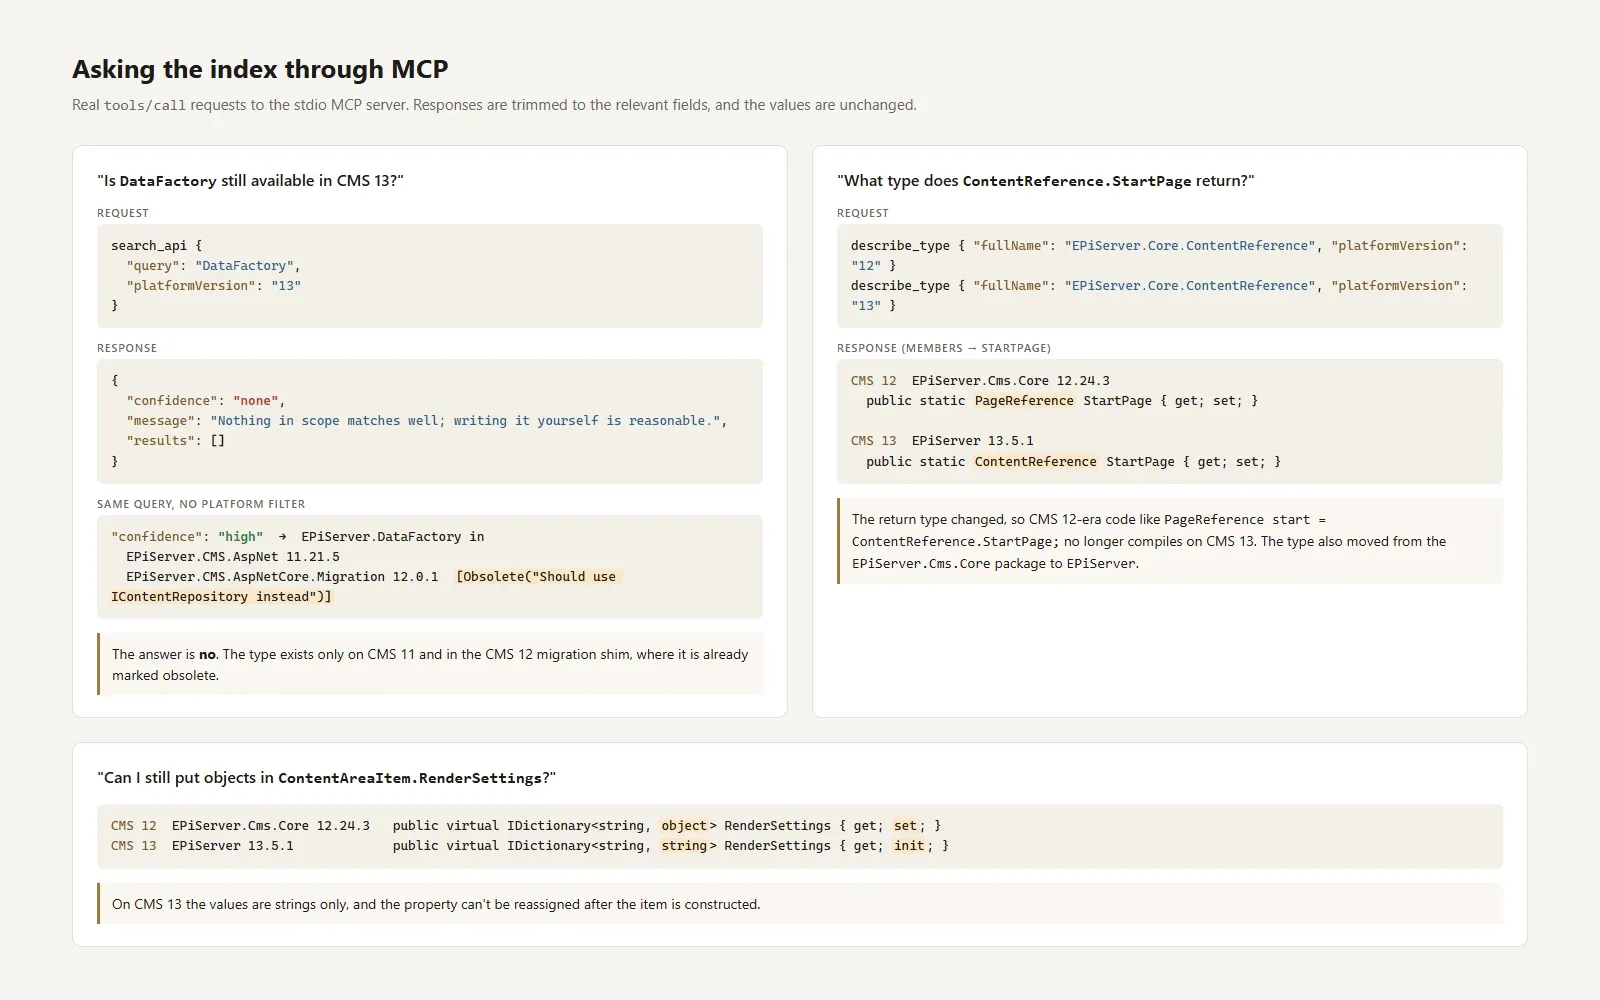
De tre kald siger det hele:
DataFactorypå CMS 13. En model, der er trænet på femten års EPiServer-blogindlæg, skriver glad og gerneDataFactory.Instance.Get<PageData>(). På CMS 13 har indekset slet ingenDataFactory. På CMS 12 overlever den kun i migreringspakken, og der er den allerede markeret som forældet.ContentReference.StartPage. Den returnerede enPageReferencepå CMS 12 og returnerer enContentReferencepå CMS 13. Kode, der lægger værdien over i enPageReference, har kompileret i årevis og gør det ikke længere.RootPage,WasteBasketogPageData.ParentLinkhar taget samme skridt.ContentAreaItem.RenderSettings. Den er gået fra at være en dictionary med objekter og en setter til en dictionary med strenge, og nu kan egenskaben kun sættes, når objektet oprettes. Intet i en models hukommelse vil advare jer.
Der gemmer sig også en mere subtil lektie. Sammenlign EPiServer.Cms.Core-pakken i 12.24.3 med 13.5.1, og omkring 1.300 typer ser ud til at være fjernet. Det er de ikke. De er flyttet over i den nye EPiServer-pakke. Opslag efter pakkenavn lyver for jer. Det gør opslag efter type og version ikke.
Mit yndlingseksempel er IContentIndexer i Optimizely Graph 13.3. Den blev hverken markeret som forældet eller udfaset. Den blev gjort internal, og det er API-verdenens udgave af ghosting. Noten om den står stadig som community, fordi versionen før ikke kan tjekkes mod pakkerne, og tillidsloftet er ligeglad med, hvor god historien er.
Hvad det kostede
Det tog 6.756 modelkald at bygge videnbasen mellem den 9. og den 14. november. Til Anthropics listepriser svarer det til 232,76 dollar, regnet ud fra vores egne token-tal, så læs det som et skøn og ikke som en faktura. Det meste gik til Sonnet, som stod for tjekket.
Den fordeling er det mest brugbare tal i hele indlægget. Læsningen er billig. Det er tjekket, der koster. En opsætning, der springer tjekket over for at spare penge, giver jer en stor bunke selvsikker Markdown, og det er nogenlunde, hvad modellen allerede havde i hovedet.
Viden har en holdbarhedsdato
Videnbasen er ikke færdig, og det siger jeg hellere selv. Intet kører efter en fast tidsplan endnu, og det er det største hul. Optimizely udgiver nye pakkeversioner med få ugers mellemrum, og et par hundrede noter henviser stadig til CMS 13.4.1 og er ikke blevet tjekket igen mod 13.5.1. En videnbase, som ingen opdaterer, ender som det blogindlæg fra 2014, den skulle erstatte.
Næste skridt er derfor et planlagt job, der opdaterer videnbasen automatisk, og sådan ville jeg sætte det op:
- Hold øje med feedet. Når en ny pakkeversion udkommer, så indeksér den og sammenlign dens API med den forrige version.
- Markér de noter, en ændring rammer. Når en type ændrer sig, kommer alle noter, hvis
applies_todækker typen, tilbage i køen til verificering. Indtil de er tjekket igen, sænkes deresconfidence. - Høst det nye. Hent release notes, nyt fra Optimizely World og nye blogindlæg siden sidste kørsel, og send det gennem den samme proces med læsning og verificering som alt andet.
- Lad et menneske godkende. Jobbet opretter en pull request, der viser, hvad det har ændret og hvorfor, i stedet for at ændre direkte i videnbasen. Agenterne kan godt stå for tjekket, men nogen bør stadig læse den igennem.
Kør det hver uge, eller når der kommer en ny release. Det burde koste en brøkdel af den første opbygning, for i de fleste uger har det meste af API’et ikke ændret sig.
Vi tester også et rigtigt søgeindeks og en MCP-server oven på noterne. Indtil videre finder søgeindekset den rigtige note en anelse sjældnere, end når Sonnet bare kører grep på mappen, men til en brøkdel af tokens. Grep har været ubesejret siden 1973, så det kan jeg godt leve med.
Mit råd til jer
Giv jeres agenter samme onboarding som en ny udvikler. Giv dem jeres værktøjer, jeres procedurer og den framework-viden, jeres bedste folk går rundt med. De er geniale, men de er nye her.
Skriv det ned, hvor alle agenter kan finde det. En gotcha, som én session brændte fingrene på, bør koste den næste session en søgning, ikke en eftermiddag. Almindelige filer i git er en udmærket begyndelse.
Opdatér videnbasen efter en fast tidsplan. Frameworks flytter sig. Tjek de noter igen, som en ny release rører ved, høst det nye, og lad et menneske godkende ændringerne.
Stol mere på den kompilerede kode end på blogs. Giv hver kilde et tillidsloft, og lad kun pakkerne eller kørende kode løfte en påstand til verified. For Optimizely betyder det et indeks over, hvad der faktisk ligger i NuGet-pakkerne, version for version.
Registrér modsigelser i stedet for at afgøre dem. “Blogs siger ja, FAQ’en og pakkerne siger nej” er brugbar viden. At vælge den ene og gemme den anden væk er det ikke.
Betal for tjekket. Lad den billige model læse og den bedre model verificere. Det er i verificeringen, værdien ligger.
Hvis I vil have sådan en videnbase til jeres egen platform, hvad enten det er Optimizely eller noget helt andet, så kontakt os. Vi kan sætte den op for jer: høsten, verificeringen mod jeres pakkeversioner og adgangen fra de værktøjer, jeres agenter allerede bruger. Optimizely er det, vi laver, og det viser sig, at det meste af jobbet er at lære agenter et framework.
En sidebemærkning til sidst. Opsummeringerne af, hvad hver pakkes typer bruges til, er skrevet af en model, og i NuGet-indekset bliver det til rigtig mange opsummeringer. Så jeg trænede min egen lille model til at skrive dem. Nogle steder gik det bedre, end jeg havde regnet med, og andre steder gik det meget værre. Det handler næste indlæg om.
Jeres agenter er allerede geniale. Det er uvidenheden, I kan gøre noget ved, og I skal kun gøre det én gang.